Kubernetes in produzione: gli errori che costano di più alle aziende italiane (e come non commetterli)
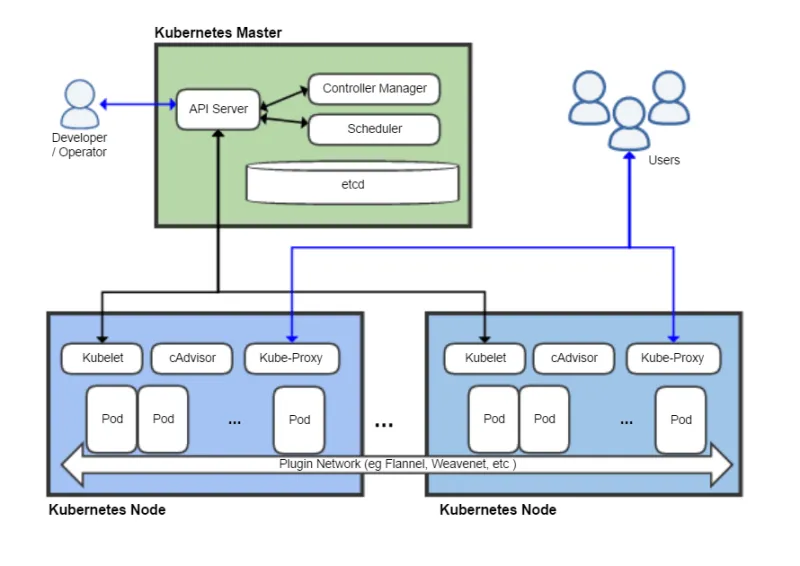
Photo: Khtan66, CC BY-SA 4.0, via Wikimedia Commons
Kubernetes è diventato lo standard de facto per l'orchestrazione di container in ambienti enterprise. Eppure, la distanza tra un cluster funzionante in ambiente di test e uno realmente production-ready è spesso più ampia di quanto i team IT anticipino. Nelle nostre attività di supporto e consulenza infrastrutturale, abbiamo osservato pattern ricorrenti di errori che rallentano le aziende italiane nella loro adozione di Kubernetes — con conseguenze che vanno dal semplice degrado delle performance fino a interruzioni di servizio e violazioni della sicurezza.
Di seguito analizziamo i sette errori più critici, con indicazioni operative per evitarli o correggerli.
1. Assenza di resource requests e limits nei Pod
Uno degli errori più diffusi — e più sottovalutati — è il deploy di Pod senza definire esplicitamente requests e limits per CPU e memoria. Senza questi parametri, lo scheduler di Kubernetes non dispone delle informazioni necessarie per distribuire correttamente i carichi di lavoro sui nodi, con il risultato che un singolo servizio può monopolizzare le risorse del cluster, provocando l'eviction di altri Pod o il crash dell'intero nodo.
Soluzione: Definire sempre resources.requests e resources.limits per ogni container. Utilizzare strumenti come Vertical Pod Autoscaler (VPA) in modalità recommendation per raccogliere dati reali prima di impostare valori fissi. Implementare LimitRange a livello di namespace per garantire che nessun deployment possa essere eseguito senza questi parametri.
2. Cluster a nodo singolo o senza ridondanza del control plane
Molte PMI italiane avviano la propria esperienza con Kubernetes su un cluster a nodo singolo o con un control plane non ridondato, spesso per contenere i costi iniziali. Questa scelta è accettabile in fase di sviluppo, ma diventa un rischio inaccettabile in produzione. Un singolo punto di guasto nel control plane — anche solo un aggiornamento del sistema operativo mal pianificato — può rendere irraggiungibile l'intera piattaforma.
Soluzione: In produzione, configurare sempre un control plane multi-master (almeno tre nodi etcd). Se si utilizza un servizio Kubernetes gestito come GKE, EKS o AKS, abilitare la modalità ad alta disponibilità. Per chi gestisce cluster on-premise o in ambienti ibridi, strumenti come kubeadm supportano nativamente la configurazione HA.
3. Gestione approssimativa dei segreti
Archiviare credenziali, chiavi API o certificati direttamente nelle variabili d'ambiente dei deployment, o peggio ancora all'interno delle immagini container, è una pratica ancora troppo comune. I Kubernetes Secrets nativi, se non correttamente configurati, vengono archiviati in etcd in formato base64 — che non equivale a cifratura.
Soluzione: Abilitare la cifratura at-rest per etcd. Integrare soluzioni di secrets management esterne come HashiCorp Vault, AWS Secrets Manager o Azure Key Vault tramite operatori dedicati (es. External Secrets Operator). Applicare RBAC restrittivo per limitare l'accesso ai Secret solo ai ServiceAccount che ne hanno effettiva necessità.
4. Mancanza di Network Policy
Per impostazione predefinita, Kubernetes consente la comunicazione libera tra tutti i Pod all'interno di un cluster. In un ambiente di produzione con più team, microservizi e livelli applicativi, questa configurazione equivale a lasciare tutte le porte aperte in una rete aziendale. Una compromissione di un singolo Pod potrebbe consentire il movimento laterale verso componenti critici.
Soluzione: Implementare Network Policy seguendo il principio del minimo privilegio: negare tutto il traffico per impostazione predefinita e consentire esplicitamente solo le comunicazioni necessarie. Utilizzare un CNI plugin che supporti le Network Policy (Calico, Cilium, Weave Net). Validare periodicamente le policy con strumenti di analisi come Cilium's Hubble o Kube-bench.
5. Aggiornamenti del cluster procrastinati
Kubernetes rilascia nuove versioni minori ogni quattro mesi circa, con una finestra di supporto limitata per le versioni precedenti. Molte aziende italiane tendono a rimandare gli aggiornamenti per timore di interruzioni, ritrovandosi su versioni EOL (End of Life) prive di patch di sicurezza e incompatibili con i workload più recenti.
Soluzione: Pianificare gli aggiornamenti come attività ricorrente nel calendario IT, non come intervento straordinario. Testare gli upgrade in ambiente di staging prima di applicarli in produzione. Adottare una strategia di upgrade graduale (nodo per nodo) per minimizzare il rischio di downtime. Nei cluster gestiti, sfruttare le funzionalità di upgrade automatico controllato offerte dai provider cloud.
6. Monitoring insufficiente o assente
Portare un cluster Kubernetes in produzione senza un sistema di osservabilità strutturato significa navigare a vista. Eppure, in molte realtà italiane di medie dimensioni, il monitoring si limita a verifiche manuali o ad alert generici a livello di infrastruttura, senza visibilità sullo stato dei Pod, sui consumi per namespace o sulle latenze dei servizi.
Soluzione: Implementare uno stack di osservabilità completo: Prometheus per la raccolta delle metriche, Grafana per la visualizzazione, e Alertmanager per la gestione degli alert. Aggiungere distributed tracing con Jaeger o Tempo per i microservizi. Configurare alert significativi su metriche critiche: OOMKilled events, CrashLoopBackOff, saturazione dei nodi, latenza dei pod in stato Pending. L'osservabilità non è un optional: è un prerequisito per la gestione responsabile di un cluster production.
7. RBAC configurato in modo eccessivamente permissivo
Un errore frequente, spesso ereditato da configurazioni di prova, è l'assegnazione del ruolo cluster-admin a utenti o ServiceAccount che non ne hanno bisogno. In contesti regolamentati — come quelli soggetti a GDPR o normative di settore — questa configurazione rappresenta un rischio di conformità oltre che di sicurezza.
Soluzione: Applicare il principio del minimo privilegio anche al RBAC. Creare Role e ClusterRole specifici per ogni caso d'uso, evitando di assegnare permessi su risorse wildcard. Auditare periodicamente i binding esistenti con strumenti come kubectl-who-can o Rakkess. Automatizzare la revisione dei permessi come parte del processo di onboarding e offboarding degli utenti.
Una riflessione sul contesto italiano
L'adozione di Kubernetes nelle aziende italiane è in crescita, ma spesso avviene in contesti dove le competenze interne sono ancora in fase di consolidamento. Questo non è un limite insormontabile: è una condizione di partenza che richiede un approccio strutturato, supporto specializzato e una roadmap di maturità tecnologica chiara.
Affidarsi a partner di infrastruttura con esperienza concreta nella gestione di cluster Kubernetes in produzione — sia in ambienti cloud pubblici che in configurazioni ibride — consente di ridurre significativamente il rischio operativo e di accelerare il percorso verso una piattaforma stabile e sicura.
Conclusione
Kubernetes non perdona le approssimazioni in produzione. Ogni errore di configurazione può tradursi in downtime, vulnerabilità o costi non pianificati. Ma con una strategia corretta, strumenti adeguati e un processo di revisione continua, è possibile gestire cluster Kubernetes affidabili anche con team di dimensioni contenute. Il primo passo è riconoscere gli errori più comuni — e avere la disciplina per non commetterli.