SLA realistici per infrastrutture critiche: smettere di inseguire la latenza zero e iniziare a misurare ciò che conta
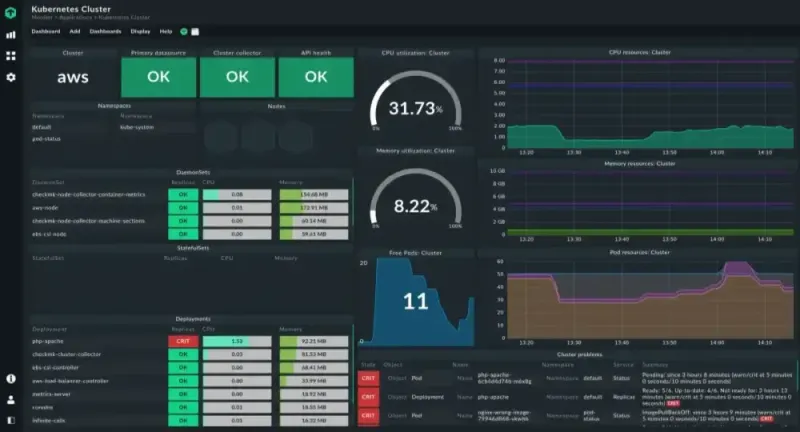
Photo: server infrastructure data center performance monitoring dashboard, via logit.io
C'è una conversazione che si ripete, quasi senza variazioni, nelle sale riunioni di molte aziende italiane. Da un lato il responsabile IT che spiega perché certi obiettivi di performance non sono tecnicamente raggiungibili. Dall'altro il management che chiede garanzie assolute su disponibilità e velocità. In mezzo, un documento chiamato Service Level Agreement che spesso non soddisfa nessuno dei due.
Il problema non è la volontà di fare bene. Il problema è che la latenza zero — come la disponibilità al 100% — è un mito tecnico che, se inseguito acriticamente, porta a sprechi di budget, architetture sovradimensionate e, paradossalmente, a infrastrutture meno resilienti di quelle progettate con criteri più realistici.
Perché la latenza zero non esiste (e non esisterà mai)
La velocità della luce nel vuoto è circa 299.792 km/s. Nella fibra ottica, a causa dell'indice di rifrazione del vetro, scende a circa 200.000 km/s. Una richiesta che viaggia da Milano a Roma percorre circa 600 km: anche in condizioni ideali, senza nessun hop intermedio, nessun firewall, nessun load balancer, il tempo di transito fisico minimo è nell'ordine dei 3 millisecondi.
Aggiungiamo la realtà operativa: switching, routing, elaborazione applicativa, query al database, serializzazione e deserializzazione dei dati. Anche un'applicazione ottimizzata in modo eccellente, ospitata in un datacenter italiano con connettività premium, opera in un contesto dove la latenza ha un pavimento fisico invalicabile.
Questo non significa rassegnarsi a performance scadenti. Significa costruire SLA che partano da una baseline misurabile e non da un'aspirazione.
Il costo nascosto degli SLA troppo ambiziosi
Definire un SLA irrealistico non è solo un errore tecnico: è un rischio economico e contrattuale. Quando un'azienda si impegna — internamente o verso i propri clienti — a garantire una disponibilità del 99,999% (i famosi "cinque nove"), sta accettando un budget di downtime annuo di circa 5 minuti e 15 secondi.
Raggiungerlo richiede ridondanza attiva su ogni singolo componente della catena: alimentazione, rete, storage, compute, applicazione. Il costo infrastrutturale di questo livello di ridondanza è esponenziale rispetto ai livelli immediatamente inferiori. Quattro nove (99,99%) consentono circa 52 minuti di downtime all'anno e richiedono investimenti significativamente più contenuti.
La domanda corretta non è "quanto alta possiamo spingere la disponibilità?" ma "qual è il costo del downtime per il nostro business e quanto siamo disposti a investire per ridurlo?"
Un framework decisionale in quattro passi
Per costruire SLA che abbiano senso per la tua organizzazione, Net-Point suggerisce un approccio strutturato in quattro fasi:
1. Classificazione dei servizi per criticità
Non tutti i sistemi hanno lo stesso impatto sul business. Un CRM interno ha requisiti diversi da un gateway di pagamento e-commerce. Mappare i servizi per impatto economico, regolatorio e reputazionale permette di allocare le risorse dove effettivamente servono, evitando di applicare standard da mission-critical a sistemi che non lo richiedono.
2. Misurazione della baseline attuale
Prima di fissare obiettivi, è indispensabile sapere dove si parte. Strumenti di APM (Application Performance Monitoring) come Datadog, New Relic o soluzioni open source come Prometheus con Grafana permettono di raccogliere dati storici su latenza, throughput e disponibilità. Questi dati sono il fondamento su cui costruire SLA credibili.
3. Analisi dei trade-off costo/performance
Ogni miglioramento percentuale nella disponibilità o riduzione della latenza ha un costo marginale crescente. Passare dal 99% al 99,9% è relativamente economico. Passare dal 99,9% al 99,99% richiede un investimento spesso dieci volte superiore. Rendere questo trade-off esplicito, con numeri reali, trasforma la conversazione da tecnica a strategica.
4. Definizione di SLO e SLI prima degli SLA
Una best practice consolidata — resa popolare dall'approccio SRE di Google — prevede di definire prima gli Service Level Indicators (le metriche concrete: latenza al 95° percentile, error rate, throughput) e poi gli Service Level Objectives (gli obiettivi interni, più stringenti degli SLA contrattuali). Gli SLA diventano così il livello minimo garantito, non l'obiettivo di eccellenza.
I percentili contano più delle medie
Un errore frequente nella definizione degli SLA è utilizzare valori medi. Una latenza media di 200ms può nascondere il fatto che il 5% delle richieste supera i 2 secondi — un'esperienza utente disastrosa per quelle transazioni.
Lavorare con il 99° percentile (p99) o il 95° percentile (p95) della latenza fornisce una visione molto più onesta delle performance reali. Se il tuo SLA recita "latenza inferiore a 300ms al p95", stai garantendo che 95 richieste su 100 rispettino quel limite — un impegno concreto e verificabile.
Il ruolo della complessità operativa
C'è un paradosso che le organizzazioni più mature hanno imparato a riconoscere: aggiungere ridondanza e componenti per aumentare la disponibilità incrementa anche la complessità operativa, e quindi la probabilità di errori umani. Un sistema con dieci componenti ridondanti ha più punti di possibile misconfiguration rispetto a uno con cinque componenti ben gestiti.
Per le aziende italiane di medie dimensioni — spesso con team IT non particolarmente numerosi — questo significa che un'architettura più semplice, con SLA leggermente meno ambiziosi ma gestita con competenza, può offrire una disponibilità reale superiore a un'architettura iper-ridondante che nessuno sa operare correttamente.
Comunicare gli SLA internamente ed esternamente
Gli SLA non sono solo documenti tecnici: sono strumenti di governance. Internamente, aiutano i team IT a prioritizzare interventi e investimenti. Esternamente, definiscono le aspettative dei clienti e le responsabilità contrattuali.
Una comunicazione efficace degli SLA richiede linguaggio accessibile, metriche comprensibili anche ai non tecnici e procedure di escalation chiare in caso di violazione. Includere nel documento anche le esclusioni — manutenzioni programmate, eventi di forza maggiore, dipendenze da fornitori terzi — riduce il rischio di dispute e costruisce fiducia.
Conclusione: la maturità si misura nella coerenza tra impegni e capacità
Definire SLA realistici non è un atto di resa di fronte alla complessità tecnologica. È, al contrario, una dimostrazione di maturità organizzativa: la capacità di misurare con precisione, comunicare con onestà e investire con intelligenza.
Le infrastrutture digitali più affidabili non sono quelle che promettono di più, ma quelle che mantengono sistematicamente ciò che promettono. In un mercato dove la fiducia è un asset competitivo, questa coerenza vale più di qualsiasi numero sul foglio degli SLA.