Database distribuiti o centralizzati: la scelta che può fare la differenza per una startup in rapida crescita
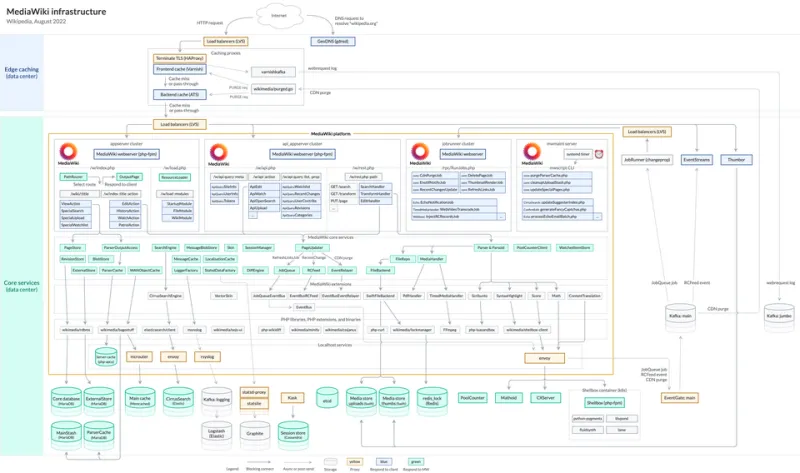
Photo: Timo Tijhof, CC0, via Wikimedia Commons
Nel momento in cui una startup inizia a registrare una crescita accelerata degli utenti, la pressione sull'infrastruttura dati diventa tangibile quasi dall'oggi al domani. Quello che funzionava perfettamente con diecimila record comincia a mostrare crepe quando i volumi si moltiplicano. La domanda che si trovano ad affrontare founder e CTO non è semplicemente tecnica: è strategica, con implicazioni dirette sui costi, sulla velocità di sviluppo e sulla capacità di competere.
In questo articolo analizziamo con concretezza le due architetture principali — database centralizzati e database distribuiti — senza ideologie, ma con l'obiettivo di fornire strumenti decisionali utili a chi deve costruire oggi le fondamenta tecnologiche di un'impresa che ambisce a scalare.
Cosa si intende davvero per database centralizzato
Un database centralizzato è, nella sua accezione più comune, un sistema in cui tutti i dati risiedono su un'unica istanza logica — o su un cluster ad alta disponibilità che si comporta come tale. PostgreSQL, MySQL, Microsoft SQL Server e Oracle rientrano in questa categoria. La gestione è relativamente semplice: un unico punto di verità, transazioni ACID garantite, strumenti di monitoraggio maturi e un ecosistema di competenze ampiamente disponibile.
Per una startup nelle prime fasi, questo approccio offre un vantaggio non trascurabile: la semplicità operativa. Con un team ridotto, la possibilità di non dover gestire la complessità di un sistema distribuito vale spesso più di qualsiasi ottimizzazione teorica.
Cosa cambia con un'architettura distribuita
I database distribuiti — tra cui Cassandra, CockroachDB, MongoDB in configurazione sharded, o i servizi gestiti come Amazon DynamoDB e Google Spanner — suddividono i dati tra più nodi, spesso in aree geografiche diverse. Il vantaggio principale è la scalabilità orizzontale: aggiungere capacità significa aggiungere nodi, senza dover riprogettare l'architettura.
Tuttavia, questa flessibilità ha un prezzo. Il teorema CAP — che afferma l'impossibilità di garantire simultaneamente consistenza, disponibilità e tolleranza alle partizioni di rete — non è solo una curiosità accademica. È una realtà operativa che si manifesta ogni volta che un nodo va offline o che la rete introduce latenza tra le repliche. I team che non hanno familiarità con questi scenari possono trovarsi a gestire anomalie difficili da diagnosticare e da correggere.
Il confronto sui tre assi decisivi
Scalabilità
La scalabilità verticale — aumentare le risorse di un singolo server — ha limiti fisici ed economici. Un database centralizzato ben configurato può gestire carichi molto elevati, ma oltre una certa soglia il costo per unità di prestazione aumenta in modo non lineare. I database distribuiti, al contrario, scalano orizzontalmente in modo più prevedibile, rendendoli adatti a workload con picchi imprevedibili o con una crescita sostenuta nel tempo.
Una startup italiana nel settore dell'e-commerce, ad esempio, potrebbe gestire tranquillamente i primi due anni su PostgreSQL con repliche di lettura, per poi valutare la migrazione a un'architettura distribuita solo quando i volumi giornalieri superano determinate soglie — tipicamente nell'ordine di centinaia di milioni di operazioni al giorno.
Consistenza dei dati
Questa è la dimensione in cui le differenze diventano più critiche. Un database centralizzato garantisce per default la consistenza forte: ogni lettura riflette l'ultima scrittura confermata. In un sistema distribuito, la consistenza eventuale — dove le repliche si sincronizzano con un ritardo misurabile — è spesso il compromesso accettato per ottenere disponibilità e performance geografica.
Per applicazioni finanziarie, sistemi di prenotazione o qualsiasi contesto in cui la correttezza del dato è non negoziabile, la consistenza forte è un requisito che non si può sacrificare. Per piattaforme social, sistemi di raccomandazione o analytics in tempo reale, la consistenza eventuale è spesso accettabile — e talvolta preferibile.
Costi operativi
Il costo totale di possesso è spesso sottovalutato nella fase di scelta. Un database distribuito gestito internamente richiede competenze specialistiche difficili da trovare sul mercato italiano e una curva di apprendimento significativa. I servizi gestiti dai principali cloud provider riducono questo overhead, ma introducono un vincolo di vendor lock-in che merita una valutazione attenta.
Un approccio pragmatico adottato da diverse startup europee prevede l'utilizzo di database centralizzati gestiti — come Amazon RDS o Google Cloud SQL — nelle prime fasi, con la possibilità di migrare verso soluzioni distribuite quando la crescita lo giustifica. Questo approccio consente di contenere i costi iniziali mantenendo aperta la porta all'evoluzione.
Due storie, due scelte diverse
Una piattaforma SaaS di gestione documentale con sede a Milano ha scelto fin dall'inizio CockroachDB per garantire la disponibilità multi-regione richiesta dai propri clienti enterprise. Il risultato è stato positivo in termini di uptime, ma il team ha impiegato quasi sei mesi per padroneggiare il sistema e risolvere problemi legati alla gestione delle transazioni distribuite. Un investimento che si è rivelato corretto solo perché il prodotto aveva già clienti con SLA esigenti fin dal lancio.
Al contrario, una startup fintech romana ha costruito l'intera infrastruttura su PostgreSQL, scalando verticalmente e ottimizzando le query per tre anni prima di valutare alternative. Quando i volumi lo hanno richiesto, ha introdotto repliche di lettura e partitioning, evitando la complessità di un sistema distribuito in una fase in cui il team era ancora in crescita. La semplicità ha permesso di mantenere alta la velocità di sviluppo del prodotto.
Quando ha senso scegliere il distribuito fin dall'inizio
Esistono scenari in cui optare subito per un'architettura distribuita è la scelta corretta. Il principale è la presenza di requisiti multi-regione sin dal lancio: se il prodotto deve servire utenti in Europa, Nord America e Asia con latenze basse e continuità garantita, un database distribuito geograficamente è difficile da evitare.
Un secondo scenario riguarda workload con caratteristiche di scrittura massiva e eterogeneità dei dati — tipico di applicazioni IoT, piattaforme di streaming di eventi o sistemi di log analytics — dove i modelli di dati non relazionali e la scalabilità orizzontale sono vantaggi strutturali.
Una raccomandazione operativa
La scelta tra database centralizzato e distribuito non dovrebbe essere guidata dalla tecnologia più moderna o da ciò che usano le grandi piattaforme globali. Dovrebbe partire da una domanda concreta: qual è il workload atteso nei prossimi dodici-ventiquattro mesi, e quali sono i requisiti non negoziabili in termini di consistenza e disponibilità?
In assenza di requisiti specifici che giustifichino la complessità, un database relazionale centralizzato — ben progettato, ben monitorato e ospitato su infrastruttura cloud affidabile — rimane la scelta più solida per la maggior parte delle startup in fase di crescita. La complessità si introduce quando il problema lo richiede, non in anticipo.
In Net-Point supportiamo le aziende italiane nella progettazione e nella gestione di infrastrutture dati scalabili, aiutando i team tecnici a valutare le opzioni disponibili con un approccio concreto e orientato agli obiettivi di business.