Quando il monitoraggio non basta: il salto dall'alerting tradizionale all'observability per infrastrutture complesse
Photo: The U.S. Army, Public domain, via Wikimedia Commons
Era un venerdì pomeriggio quando il sistema di e-commerce di un distributore lombardo ha iniziato a rallentare. Nessun alert si è attivato: CPU nella norma, memoria stabile, database che rispondeva regolarmente. Eppure il tasso di conversione stava crollando. Ci sono volute quattro ore di analisi manuale per scoprire che un aggiornamento del servizio di raccomandazione prodotti stava generando query inusuali che, individualmente, rientravano nelle soglie configurate, ma in combinazione saturavano un pool di connessioni condiviso.
Questo scenario — purtroppo non raro — illustra il limite fondamentale del monitoraggio tradizionale: funziona bene per i problemi che hai già visto, e male per tutto il resto.
La differenza che cambia tutto
Il monitoraggio tradizionale è orientato alle risposte: definisci metriche, imposti soglie, ricevi alert quando qualcosa supera quei limiti. È un approccio deduttivo che presuppone di sapere in anticipo quali domande fare all'infrastruttura.
L'observability, invece, è orientata alle domande: costruisce un sistema in cui puoi interrogare il comportamento dell'infrastruttura in modo esplorativo, anche per scenari che non hai mai anticipato. Il termine, mutuato dalla teoria dei sistemi di controllo, indica la capacità di inferire lo stato interno di un sistema osservandone gli output.
In pratica, la distinzione si manifesta nel momento in cui ricevi una segnalazione di degrado: con il monitoring tradizionale, puoi verificare se le metriche che hai configurato sono fuori soglia. Con l'observability, puoi navigare tra i dati per capire perché qualcosa si comporta in modo anomalo, anche se non avevi previsto quella specifica anomalia.
I tre pilastri dell'observability moderna
L'observability si costruisce su tre tipologie di dati, spesso chiamate i "tre pilastri":
Metriche (Metrics) Serie temporali di valori numerici aggregati: CPU usage, richieste al secondo, latenza media. Sono efficienti da raccogliere e archiviare, ma per loro natura perdono il contesto delle singole operazioni. Sono l'erede diretto del monitoring tradizionale.
Log Registrazioni discrete di eventi: ogni riga rappresenta qualcosa che è accaduto, con timestamp, contesto e dettagli. Ricchi di informazioni ma difficili da analizzare su larga scala senza strumenti adeguati. Il problema non è la quantità di log — è la capacità di correlarli in modo significativo.
Tracce distribuite (Distributed Traces) Questo è il pilastro che più distingue l'observability moderna dal monitoring tradizionale. Una traccia segue il percorso di una singola richiesta attraverso tutti i servizi e componenti che attraversa, con timing precisi per ogni hop. In un'architettura a microservizi, dove una singola operazione può toccare decine di servizi, le tracce distribuite sono l'unico modo per capire dove il tempo viene effettivamente speso.
La potenza dell'observability emerge quando questi tre pilastri sono correlati: puoi partire da un'anomalia nelle metriche, scendere nei log del periodo interessato e poi seguire una traccia specifica per identificare esattamente quale componente ha introdotto latenza.
Il problema del monitoring legacy nelle infrastrutture ibride
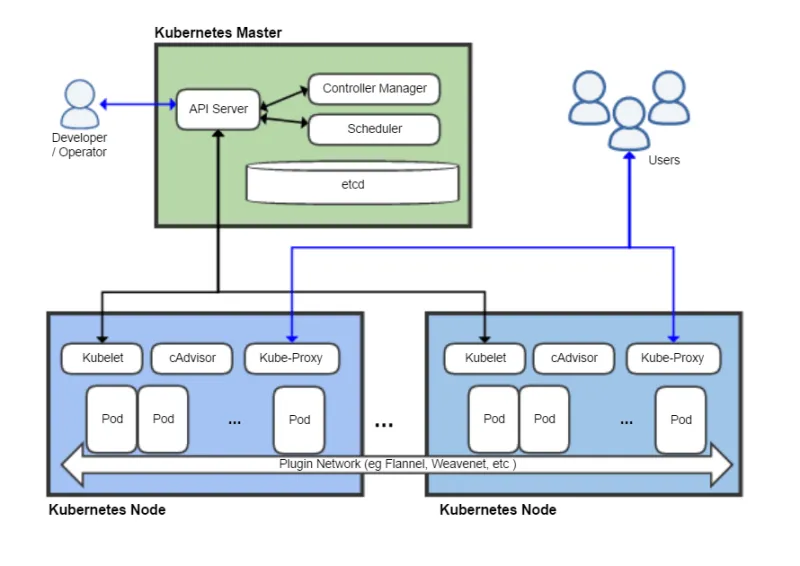
Molte aziende italiane si trovano oggi a gestire infrastrutture ibride: sistemi legacy on-premise, servizi in cloud pubblico, applicazioni containerizzate su Kubernetes, API di terze parti. In questo contesto, il monitoring tradizionale mostra i suoi limiti più evidenti.
Gli strumenti legacy come Nagios o Zabbix — ottimi per infrastrutture statiche e monolitiche — faticano a gestire la natura effimera dei container, dove i pod Kubernetes vengono creati e distrutti dinamicamente. Configurare alert per host che cambiano continuamente è un esercizio di frustrazione.
Anche strumenti più moderni, se usati solo in modalità di alerting reattivo, non colmano il gap. Un team IT che riceve cento alert al giorno sviluppa inevitabilmente una forma di alert fatigue: la saturazione da notifiche porta a ignorare segnali che, in altri contesti, avrebbero richiesto attenzione immediata.
Un caso concreto: dalla cieca reazione alla diagnosi proattiva
Una società di logistica con sede a Bologna, cliente di un provider di servizi IT, gestiva la propria piattaforma di tracking spedizioni con un approccio di monitoring tradizionale. Aveva configurato oltre 200 alert su metriche di sistema, ma continuava a ricevere segnalazioni dai clienti su ritardi nelle notifiche di consegna che i suoi strumenti non rilevavano.
Il problema: l'infrastruttura stava tecnicamente "funzionando" — le metriche di sistema erano nella norma — ma un'interazione complessa tra il servizio di geocoding, il message broker e il servizio di notifica creava ritardi intermittenti che nessuna singola metrica catturava.
Dopo l'introduzione di un sistema di observability basato su OpenTelemetry per la raccolta dei dati e Grafana Tempo per l'analisi delle tracce, il team ha potuto visualizzare per la prima volta il percorso completo di ogni notifica. In meno di una settimana, ha identificato che il servizio di geocoding introduceva latenze anomale per specifici CAP italiani — un problema mai emerso nei test perché i dati di test non replicavano la distribuzione geografica reale del traffico.
Come iniziare senza riscrivere tutto
L'adozione dell'observability non richiede necessariamente di buttare via l'esistente. Un percorso pragmatico prevede:
Fase 1 – Strumentazione progressiva Initiare con i servizi più critici, aggiungendo strumentazione OpenTelemetry (lo standard aperto de facto) per emettere tracce distribuite. Molti framework moderni — Spring Boot, Django, Node.js — supportano l'auto-instrumentazione con configurazione minima.
Fase 2 – Correlazione dei dati esistenti Integrare i log e le metriche già raccolti in una piattaforma unificata. Soluzioni come Grafana Stack (Loki per i log, Prometheus per le metriche, Tempo per le tracce) offrono un ecosistema coerente, spesso più accessibile economicamente delle alternative SaaS enterprise.
Fase 3 – Ridefinizione degli alert Passare da alert basati su soglie statiche a SLO-based alerting: invece di allertare quando la CPU supera l'80%, allertare quando il tasso di errore degli endpoint critici supera lo 0,5% o quando la latenza al p99 supera i 500ms. Questo riduce drasticamente il rumore e aumenta la rilevanza degli alert.
Fase 4 – Cultura della diagnostica L'observability è anche un cambiamento culturale. I team devono sviluppare l'abitudine di esplorare i dati proattivamente, non solo in risposta agli incident. Le sessioni di chaos engineering controllato — introdurre deliberatamente fault per verificare la capacità diagnostica — accelerano questa maturazione.
Il valore per il business: oltre la riduzione del MTTR
L'argomento più immediato per investire in observability è la riduzione del Mean Time To Resolution degli incident. Ma il valore si estende oltre la gestione delle crisi.
Un'infrastruttura osservabile permette di prendere decisioni di capacity planning basate su dati reali di comportamento del sistema, non su stime. Permette di validare l'impatto di ogni deploy in produzione con dati oggettivi. Permette ai nuovi membri del team di comprendere più rapidamente come funziona il sistema, riducendo i tempi di onboarding.
In un contesto dove la complessità delle infrastrutture digitali continua a crescere, la capacità di capire cosa sta succedendo — e perché — non è un lusso tecnico. È una competenza operativa fondamentale.
Conclusione
Il monitoring tradizionale rimane uno strumento valido per ciò che è stato progettato per fare: rilevare condizioni note in sistemi relativamente stabili. Ma nelle infrastrutture moderne — distribuite, dinamiche, composte da decine di servizi interdipendenti — non è sufficiente.
L'observability non sostituisce il monitoring: lo completa, aggiungendo la capacità di diagnosticare l'ignoto. Per i team IT italiani che gestiscono infrastrutture in continua evoluzione, fare questo salto non è una questione di moda tecnologica. È una questione di sopravvivenza operativa nel momento in cui conta di più.