Debito tecnico infrastrutturale: dalla misurazione invisibile al rimborso strategico
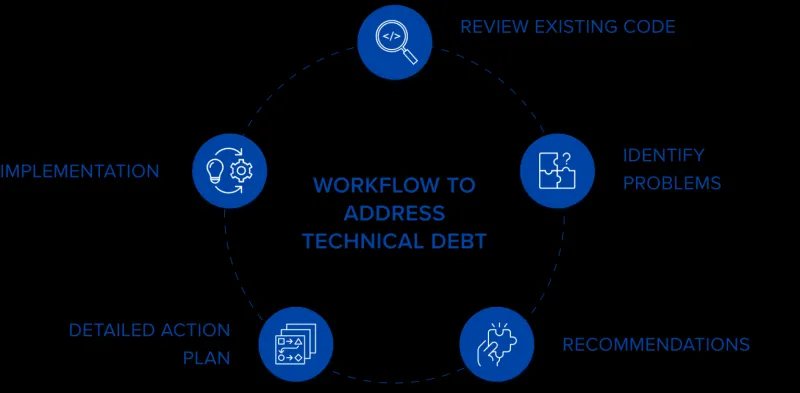
Photo: technical debt infrastructure IT management strategy office, via 10pearls.com
Nel mondo dello sviluppo software, il concetto di debito tecnico è ormai entrato nel lessico comune dei team di prodotto. Molto meno discusso, invece, è il suo corrispettivo infrastrutturale: quella massa sommersa di configurazioni obsolete, dipendenze non aggiornate, architetture pensate per un contesto che non esiste più e procedure di provisioning mantenute in vita dalla sola inerzia organizzativa.
A differenza del debito tecnico applicativo, che spesso si manifesta con bug o rallentamenti visibili, il debito tecnico infrastrutturale tende a restare invisibile per mesi o anni. Poi, in genere nel momento peggiore possibile — un picco di traffico, un aggiornamento di sicurezza urgente, una migrazione forzata — si rivela in tutta la sua portata, trasformando un'attività di routine in un'emergenza.
Perché l'infrastruttura accumula debito più velocemente di quanto si pensi
Le ragioni sono strutturali, non casuali. I team infrastrutturali lavorano spesso sotto pressione continua: ogni nuova funzionalità applicativa richiede un ambiente, ogni picco di carico impone una risposta immediata, ogni vulnerabilità critica esige una patch da applicare senza indugio. In questo contesto, la qualità architettonica passa in secondo piano rispetto alla continuità operativa.
A questo si aggiunge una caratteristica peculiare dell'infrastruttura moderna: la sua eterogeneità. Un ambiente tipico di una media impresa italiana può comprendere server fisici legacy, macchine virtuali su hypervisor di generazioni diverse, servizi cloud distribuiti su più provider, pipeline CI/CD costruite nel corso degli anni con strumenti differenti. Ogni strato aggiunge complessità; ogni complessità non documentata diventa debito.
Infine, c'è il fattore umano: le persone che hanno progettato certe soluzioni spesso non lavorano più in azienda, e le decisioni architetturali del passato vivono soltanto in configurazioni che nessuno osa toccare per paura di rompere qualcosa.
Come misurare ciò che non si vede: framework per la quantificazione
Il primo passo per governare il debito tecnico infrastrutturale è renderlo visibile. Senza misura, non esiste priorità; senza priorità, non esiste piano di rimborso.
Un approccio efficace prevede tre dimensioni di analisi:
1. Obsolescenza tecnologica. Sistemi operativi non più supportati, versioni di middleware fuori dalla finestra di manutenzione, dipendenze con CVE critiche non risolte. Questa dimensione è la più semplice da quantificare perché i dati esistono: bastano strumenti di inventario automatico come Ansible, Puppet o soluzioni di asset management per ottenere una fotografia aggiornata. Il risultato si esprime come percentuale di componenti fuori dal ciclo di vita supportato.
2. Complessità non governata. Quante configurazioni manuali esistono nell'ambiente? Quante procedure di deployment non sono codificate? Quante eccezioni alla policy standard sono state introdotte senza documentazione? Questa dimensione richiede un audit qualitativo, ma può essere approssimata con indicatori proxy: numero di ticket di emergenza legati a configurazioni, tempo medio di onboarding di un nuovo ingegnere infrastrutturale, presenza o assenza di runbook aggiornati.
3. Costo del ritardo. Ogni componente in debito ha un costo operativo crescente nel tempo. Un sistema legacy che richiede workaround manuali consuma ore-uomo ogni settimana; un'architettura non scalabile costringe a over-provisioning costoso; una pipeline CI/CD fragile rallenta ogni release. Tradurre questi costi in euro mensili è l'argomento più efficace per coinvolgere il management.
Prioritizzare senza paralizzare: la matrice del rimborso
Una volta mappato il debito, il rischio opposto è quello di voler risolvere tutto contemporaneamente, generando una paralisi operativa che blocca sia la manutenzione ordinaria sia lo sviluppo di nuove funzionalità.
Un framework pratico per la prioritizzazione incrocia due variabili: impatto sul rischio operativo (quanto è probabile che questo elemento generi un incidente nei prossimi sei mesi?) e costo del rimborso (quante risorse — tempo, denaro, competenze — servono per risolverlo?).
Gli elementi ad alto rischio e basso costo di rimborso sono le priorità assolute: vanno affrontati subito, spesso nell'ambito della normale manutenzione. Gli elementi ad alto rischio e alto costo richiedono un progetto dedicato con budget esplicito. Gli elementi a basso rischio possono essere inseriti nel backlog infrastrutturale e affrontati progressivamente, integrandoli nelle attività ordinarie di sprint o nei cicli di rilascio.
Questo approccio ha un vantaggio comunicativo non trascurabile: trasforma il debito tecnico da problema astratto a portafoglio di interventi con costi e benefici misurabili, un linguaggio che i CFO e i CTO capiscono molto meglio di qualsiasi discussione tecnica.
Comunicare il ROI del rimborso tecnico ai decision maker
Uno degli ostacoli più frequenti nella gestione del debito infrastrutturale non è tecnico, ma comunicativo. I team IT faticano a ottenere budget per attività di refactoring perché non producono funzionalità visibili all'utente finale, e il loro valore è intrinsecamente preventivo: si misura in incidenti che non accadono, in rallentamenti che non si verificano, in vulnerabilità che non vengono sfruttate.
Per superare questa resistenza, è utile adottare un approccio narrativo basato su tre elementi:
- Scenari di rischio concreti: non "questo sistema è obsoleto" ma "se questo sistema non viene aggiornato entro sei mesi, una vulnerabilità nota potrebbe esporre i dati dei clienti, con implicazioni legali ai sensi del GDPR e un potenziale impatto reputazionale stimabile in X".
- Confronto con il costo dell'emergenza: il costo di un intervento pianificato è quasi sempre una frazione del costo di una risposta a un incidente. Documentare il costo degli ultimi tre incidenti infrastrutturali — in ore di downtime, in interventi straordinari, in perdita di produttività — fornisce un termine di confronto immediato.
- Metriche di progresso: definire indicatori che mostrino il miglioramento nel tempo — riduzione del numero di componenti fuori supporto, aumento della copertura con Infrastructure as Code, diminuzione del tempo medio di recovery — trasforma il debito da problema irrisolvibile a progetto con traguardi misurabili.
Integrare il rimborso nel flusso di lavoro ordinario
Il modello più sostenibile non è quello del grande progetto di risanamento infrastrutturale — costoso, rischioso e spesso incompiuto — ma quello dell'integrazione continua del rimborso nel normale ciclo operativo.
Alcune pratiche concrete:
- La regola del 20%: riservare una quota fissa dello sprint o del ciclo di manutenzione ad attività di riduzione del debito, indipendentemente dalle pressioni di delivery. Anche il 10% è meglio di zero, perché impedisce l'accumulo ulteriore.
- Il principio del boy scout: ogni volta che un componente infrastrutturale viene modificato per qualsiasi ragione, lasciarlo in condizioni migliori di come lo si è trovato. Aggiornare la documentazione, codificare una configurazione manuale, applicare un aggiornamento minore in attesa di quello maggiore.
- Post-mortem strutturati: ogni incidente infrastrutturale dovrebbe produrre non solo un'analisi della causa radice, ma anche una valutazione del debito tecnico che ha contribuito all'evento. Questo crea un collegamento diretto tra debito e rischio operativo, alimentando il processo di prioritizzazione.
Conclusione: governare l'infrastruttura invece di subirla
Il debito tecnico infrastrutturale non è una condizione patologica da evitare a tutti i costi — è una caratteristica fisiologica di qualsiasi sistema in evoluzione. Il problema non è la sua esistenza, ma la sua invisibilità e la sua gestione reattiva.
Le organizzazioni che riescono a trasformare il debito da emergenza a voce di bilancio gestita acquisiscono un vantaggio competitivo concreto: ambienti più stabili, delivery più veloci, costi operativi prevedibili e una capacità di risposta agli imprevisti che non dipende dall'eroismo individuale dei team tecnici.
In Net-Point siamo convinti che un'infrastruttura digitale sana non sia il risultato di investimenti straordinari, ma di una disciplina ordinaria applicata con metodo. Misurare, prioritizzare, comunicare e rimborsare in modo continuo: è questo il ciclo che separa le infrastrutture che reggono la crescita del business da quelle che la frenano.