Strategie di caching per infrastrutture distribuite: performance e coerenza dei dati non sono nemici
Photo: NiiPii09, CC0, via Wikimedia Commons
Nel panorama delle infrastrutture digitali moderne, la latenza rappresenta uno dei principali indicatori di qualità del servizio. Eppure, ridurla in modo indiscriminato può introdurre rischi altrettanto gravi: dati obsoleti, inconsistenze tra nodi, comportamenti imprevedibili sotto carico elevato. La vera sfida non è scegliere tra velocità e affidabilità, ma trovare il punto di equilibrio corretto per il proprio contesto applicativo.
In questo articolo esploriamo le strategie di caching più diffuse nelle infrastrutture distribuite, con un approccio pragmatico pensato per i team IT delle aziende italiane che gestiscono ambienti complessi e non possono permettersi compromessi sulla qualità del dato.
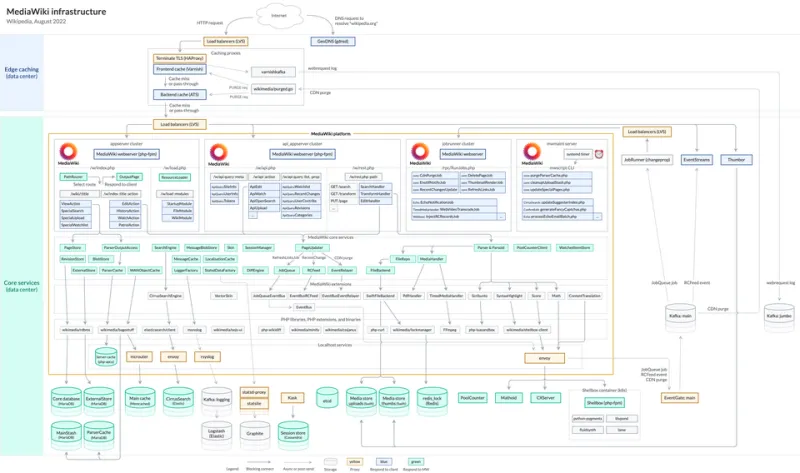
Caching centralizzato vs distribuito: non è solo una questione di topologia
La prima distinzione da fare è quella tra caching centralizzato e distribuito, due approcci che rispondono a esigenze fondamentalmente diverse.
Un sistema di caching centralizzato si basa su un singolo nodo (o un cluster ristretto) che funge da punto di riferimento per tutte le richieste. Questa architettura è più semplice da gestire, offre una visione unitaria dei dati e riduce i problemi di coerenza. Il rovescio della medaglia è evidente: rappresenta un potenziale single point of failure e non scala orizzontalmente con la stessa efficacia delle soluzioni distribuite.
Il caching distribuito, invece, replica o partiziona i dati tra più nodi geograficamente o logicamente separati. I vantaggi in termini di throughput e resilienza sono significativi, ma emergono nuove complessità: come garantire che tutti i nodi abbiano una visione coerente del dato? Come gestire gli aggiornamenti in modo atomico? Queste domande non hanno risposte universali — dipendono dal tipo di dato, dalla frequenza di aggiornamento e dalla tolleranza dell'applicazione verso la lettura di valori temporaneamente non aggiornati.
I pattern fondamentali: cache-aside, write-through e write-behind
Indipendentemente dall'architettura scelta, esistono alcuni pattern consolidati che definiscono il comportamento del layer di caching in relazione al database sottostante.
Cache-aside (o lazy loading) è il pattern più adottato nelle applicazioni web. L'applicazione verifica prima la presenza del dato in cache; in caso di miss, interroga il database, inserisce il risultato in cache e lo restituisce al chiamante. È un approccio flessibile e resiliente: se la cache non è disponibile, il sistema continua a funzionare. Il limite principale riguarda la finestra temporale tra l'aggiornamento del database e l'invalidazione della cache, che può portare a letture di dati non aggiornati.
Write-through risolve in parte questo problema: ogni scrittura avviene contemporaneamente sulla cache e sul database. Il vantaggio è una coerenza maggiore; lo svantaggio è la latenza aggiuntiva introdotta nella fase di scrittura, che può diventare critica in scenari ad alta frequenza di aggiornamento.
Write-behind (o write-back) inverte la priorità: i dati vengono scritti prima nella cache e successivamente propagati al database in modo asincrono. Questa strategia massimizza le performance in scrittura ma introduce un rischio concreto di perdita di dati in caso di failure prima che la sincronizzazione sia completata. È adatta per casi d'uso dove la perdita occasionale di un aggiornamento è accettabile — ad esempio, contatori di visualizzazioni o metriche aggregate.
L'invalidation event-driven: quando il TTL non è sufficiente
Uno dei meccanismi più tradizionali per mantenere la coerenza della cache è il TTL (Time To Live): ogni record ha una scadenza, trascorsa la quale viene considerato obsoleto e rimosso. È una soluzione semplice, ma non sempre adeguata.
In contesti dove i dati cambiano in modo imprevedibile o dove la coerenza in tempo reale è critica — si pensi a sistemi di prenotazione, piattaforme e-commerce con inventario in tempo reale o applicazioni finanziarie — il TTL introduce comunque una finestra di inconsistenza difficile da controllare.
L'approccio event-driven all'invalidazione della cache si basa su un modello a messaggi: ogni volta che un dato viene modificato nel database, viene pubblicato un evento (ad esempio tramite Kafka, RabbitMQ o il meccanismo di pub/sub integrato in Redis). I consumer interessati ricevono la notifica e invalidano o aggiornano il record corrispondente nella cache. Il risultato è un sistema più reattivo, in grado di ridurre significativamente la finestra di inconsistenza senza dover ricorrere a TTL aggressivi che aumentano il tasso di cache miss.
Questa architettura richiede una maggiore complessità infrastrutturale, ma nelle realtà italiane che operano con dati sensibili o ad alta volatilità rappresenta spesso la scelta più responsabile.
Redis Cluster e Memcached: strumenti diversi per esigenze diverse
Nel contesto degli strumenti disponibili, Redis e Memcached rimangono i riferimenti principali per il caching applicativo, ma le loro caratteristiche li rendono adatti a scenari distinti.
Memcached è progettato per essere semplice e velocissimo. Supporta solo strutture dati di tipo stringa, non offre persistenza nativa e non gestisce la replica automatica dei dati tra nodi. È la scelta ideale per caching puramente volatile, dove la semplicità operativa e la velocità di accesso sono prioritarie rispetto alla ricchezza funzionale.
Redis, e in particolare Redis Cluster, offre un set di funzionalità molto più ampio: strutture dati native (liste, set, hash, sorted set), persistenza su disco, replica automatica, pub/sub integrato e supporto alle transazioni. Redis Cluster estende queste capacità a un modello distribuito con sharding automatico dei dati tra i nodi, failover gestito e alta disponibilità.
Per le infrastrutture aziendali di media e grande dimensione, Redis Cluster rappresenta oggi lo standard de facto. La sua flessibilità consente di implementare pattern complessi come l'invalidation event-driven, la gestione di sessioni distribuite e il rate limiting a livello di API, il tutto all'interno di un unico layer tecnologico.
Scegliere la strategia giusta: domande prima degli strumenti
Prima di selezionare uno strumento o un pattern, è utile porsi alcune domande concrete:
- Con quale frequenza cambia il dato? Dati a bassa volatilità (configurazioni, cataloghi prodotto) si prestano bene al TTL lungo; dati ad alta volatilità richiedono invalidazione reattiva.
- Qual è la tolleranza dell'applicazione verso dati non aggiornati? Un pannello di analytics può accettare un ritardo di qualche secondo; un sistema di pagamento no.
- Qual è il rapporto letture/scritture? Carichi fortemente orientati alla lettura beneficiano maggiormente del caching; carichi bilanciati richiedono attenzione ai costi di sincronizzazione.
- Quali sono i requisiti di disponibilità? Se la cache deve essere altamente disponibile, Redis Cluster con replica è preferibile a soluzioni centralizzate senza failover.
Rispondere a queste domande prima di disegnare l'architettura evita di cadere nel pattern antipatico del "caching come rimedio universale", che spesso introduce complessità senza benefici proporzionali.
Considerazioni operative per il contesto italiano
Le aziende italiane che adottano infrastrutture distribuite si trovano spesso a dover conciliare requisiti normativi — in particolare quelli legati al GDPR — con esigenze di performance. Il caching di dati personali richiede attenzione: è necessario garantire che le politiche di cancellazione e aggiornamento dei dati si propaghino correttamente anche al layer di cache, evitando che informazioni obsolete o revocate rimangano accessibili oltre i tempi previsti.
In questo senso, l'invalidation event-driven non è solo una scelta architetturale per le performance, ma può diventare un requisito di conformità.
Conclusione
Il caching distribuito è uno strumento potente, ma la sua efficacia dipende dalla qualità delle scelte architetturali che lo accompagnano. Non esiste un pattern universalmente corretto: esiste quello più adatto al proprio carico di lavoro, ai propri dati e ai propri obiettivi di business. Investire tempo nell'analisi di questi fattori — prima ancora di scegliere lo strumento — è il modo più efficace per costruire un layer di caching che migliori davvero le performance senza introdurre nuovi rischi.